Коротко о главномРазвернутьСвернуть
- Xiaomi представила открытую модель искусственного интеллекта CocktailASR-1.
- Она предназначена для решения одной из наиболее сложных задач в области расшифровки аудио — выделения голоса конкретного человека в ситуации, когда несколько людей говорят одновременно.
- В Xiaomi проблему условно обозначили как «эффект коктейльной вечеринки».
Xiaomi представила открытую модель искусственного интеллекта CocktailASR-1. Она предназначена для решения одной из наиболее сложных задач в области расшифровки аудио — выделения голоса конкретного человека в ситуации, когда несколько людей говорят одновременно.
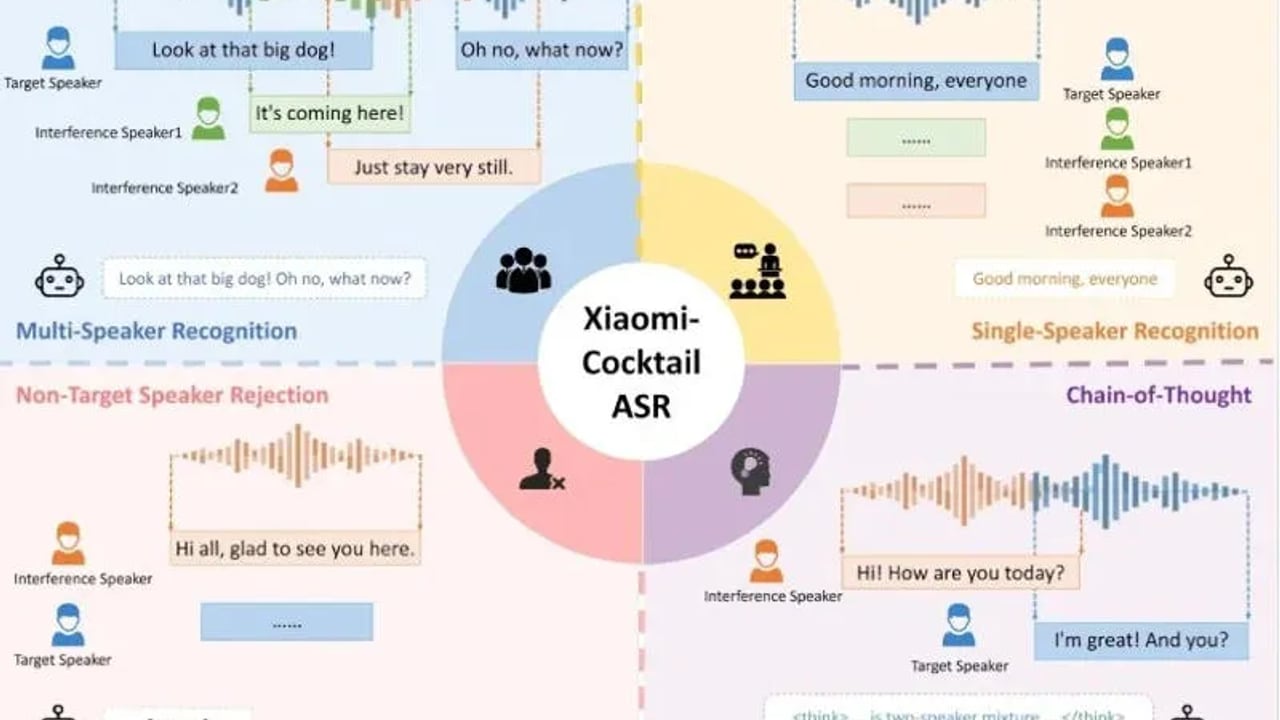
В Xiaomi проблему условно обозначили как «эффект коктейльной вечеринки». Большинство специализированных ИИ-моделей справляются с распознаванием речи, когда говорит один человек, но если друг на друга накладываются несколько голосов, ситуация значительно усложняется. Текст искажается, предложения сливаются, а реплики приписываются не тем собеседникам. В обратном направлении компания решила эту задачу с моделью OmniVoice — CocktailASR-1 же не генерирует, а выделяет и расшифровывает речь. Для работы с моделью необходимо представить короткий образец с голосом нужного человека. Она использует его как эталон, а затем, проанализировав запись с несколькими участниками, распознает и расшифрует речь только этого человека.
В ряде тестов по распознаванию речи в условиях многоголосных образцов она, отметили в Xiaomi, продемонстрировала ведущие результаты и превзошла существующие аналоги, предназначенные для решения той же задачи. Сложными условиями её возможности не исчерпываются — она умеет расшифровывать речь и в том случае, когда на записи голос только одного человека. Она также умеет избегать необоснованных предположений: если в предложенной записи указанный в качестве образца голос отсутствует, она выдаст пустой текст и не будет пытаться расшифровать слова другого человека.
Наконец, у Xiaomi CocktailASR-1 есть режим цепочки рассуждений — он позволяет пользователям изучать логику, на основе которой выполнялась расшифровка, а не просто видеть итоговый текст. Новая модель доступна на GitHub и Hugging Face .