Коротко о главномРазвернутьСвернуть
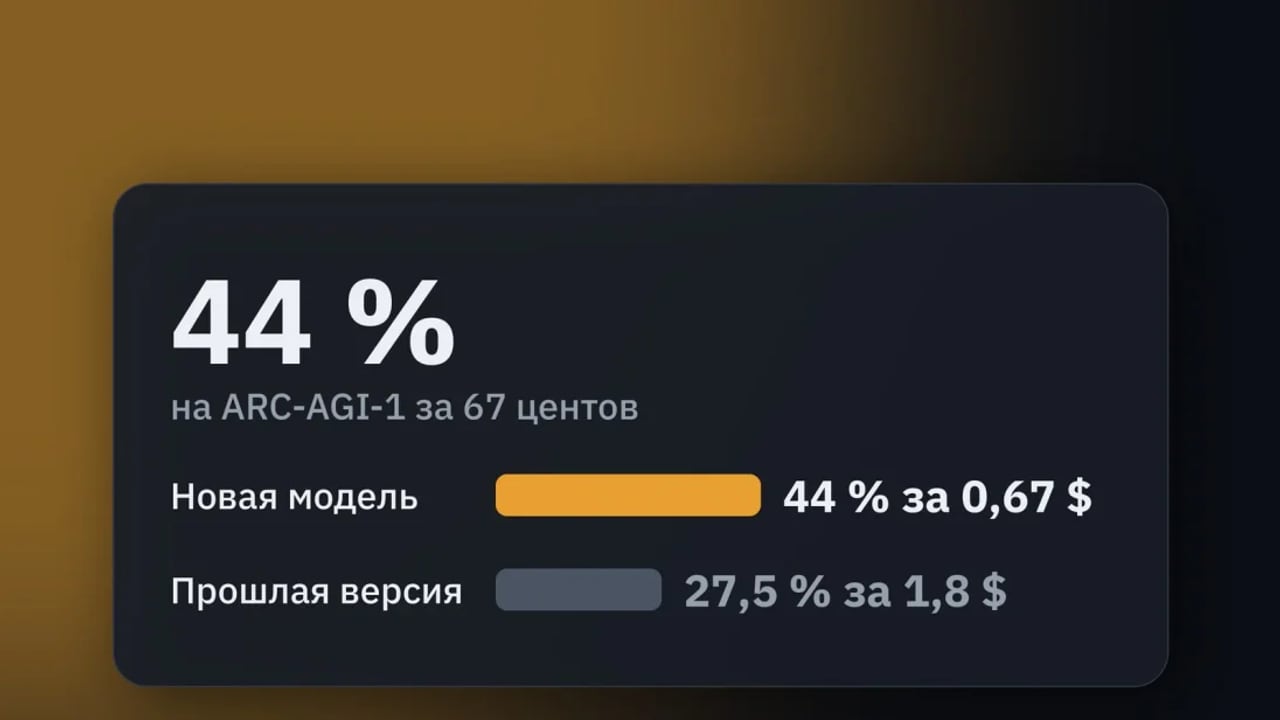
- Исследователь Митхил Вакде 1 сентября опубликовал результат: трансформер, обученный с нуля, набрал 44% на публичном оценочном наборе ARC-AGI-1.
- Обучение заняло полтора часа на одной RTX 5090, а полную стоимость вычислений автор оценивает в 67 центов при аренде видеокарты.
- Для сравнения: этот же бенчмарк несколько лет считался непосильным для больших языковых моделей, а сейчас его проходят системы, стоящие на порядки дороже.
Исследователь Митхил Вакде 1 сентября опубликовал результат: трансформер, обученный с нуля, набрал 44% на публичном оценочном наборе ARC-AGI-1. Обучение заняло полтора часа на одной RTX 5090, а полную стоимость вычислений автор оценивает в 67 центов при аренде видеокарты. Для сравнения: этот же бенчмарк несколько лет считался непосильным для больших языковых моделей, а сейчас его проходят системы, стоящие на порядки дороже.
Код открыт под лицензией MIT, и эксперимент можно повторить на арендованной видеокарте. Это главное, что отличает публикацию от очередного заявления о «прорыве»: цифры проверяемы. Оговорка тоже есть: на более новом ARC-AGI-2 та же модель даёт лишь 7%.
Что такое ARC и почему 44% это много
ARC-AGI-1 состоит примерно из 1000 задач, в каждой из которых нужно по нескольким парам «вход-выход» на цветных сетках угадать правило и применить его к новому входу. Правило у каждой задачи своё, поэтому запомнить ответы нельзя: модель должна вывести закономерность из двух-трёх примеров. Именно поэтому бенчмарк много лет держался против языковых моделей и сейчас служит аргументом в спорах о том, умеют ли нейросети «рассуждать».
Автор превращает пары сеток в последовательности токенов и обучает модель авторегрессионно, как языковую. Ключевая особенность подхода: обучение происходит во время теста, на train- и eval-задачах, при этом тестовые ответы скрыты. Для переноса знаний между задачами используется отдельный обучаемый additive embedding на каждую задачу, а для двухмерной геометрии сеток применяются обучаемые 3D RoPE embeddings.
Что изменилось с прошлой версии
Это третья публикация автора об ARC. В репозитории зафиксирован старый результат: 27,5% за $1,8 на A100. Новый: 44% за примерно $0,67 на RTX 5090. Список изменений в архитектуре выглядит как чек-лист современных практик: число слоёв выросло с 4 до 8, GELU заменён на SwiGLU, LayerNorm на RMSNorm, для обучения используется flash attention с переменной длиной последовательностей, для inference flex attention.
Самое любопытное изменение касается функции потерь. Когда автор убрал обучение на входных токенах, то есть перестал заставлять модель предсказывать сами входные сетки, результат вырос с 40% до 44%. Его комментарий честен: «Я не понимаю почему» (перевод редакции). Второе изменение: в обучение добавили задачи из ARC-2, предварительно удалив 773 задачи, которые повторяют ARC-1, чтобы не было утечки ответов. Без этих данных модель остаётся на уровне около 40%, но требует примерно вдвое больше вычислений.
Ограничения, которые стоит учесть
- Результат получен на публичном eval-наборе, а не на закрытом тесте организаторов ARC Prize; сравнивать напрямую с лидербордом нельзя.
- Обучение во время теста на eval-задачах допустимо по правилам, но делает модель узко заточенной: на ARC-2 она даёт 7%.
- Стоимость $0,67 считает только аренду видеокарты для финального прогона; на критику расчёта автор отвечает, что сумма честная, но эксперименты до этого прогона в неё не входят.
- Замер одного человека без независимого воспроизведения; код открыт, так что воспроизвести может любой.
Как повторить
По README репозитория нужна CUDA версии выше 12.8, желательно 13.0 и новее, и видеокарта класса RTX 5090; автор арендовал её через vast.ai. Минимальные требования к памяти видеокарты автор не приводит: подтверждён только запуск на RTX 5090, и на карте с меньшей памятью параметры обучения придётся подбирать самостоятельно.
По нашей оценке, значение работы не в конкретных 44%, а в демонстрации, что для ARC-1 не нужны ни сотни миллиардов параметров, ни дорогие цепочки рассуждений: достаточно правильно устроенного обучения на самих задачах. Что это говорит о бенчмарке, спорят давно; организаторы ARC Prize уже ответили выпуском ARC-2, где та же модель проваливается.
Редакция проверит, появятся ли независимые воспроизведения результата и попробует ли автор те же приёмы на ARC-2.
Источники: Блог Митхила Вакде: 44% on ARC-1 , Репозиторий mvakde/mdlARC