Коротко о главномРазвернутьСвернуть
- С 1 по 9 сентября 2026 года в открытый доступ вышли модели на любой размер железа: Nex-N2.
- 5-Max на 1,6 трлн параметров для кластера из 16 ускорителей H200, шесть моделей K2 Horizon от 0,9 до 375 млрд под Apache 2.
- 0 и MiniCPM5-2B на 2,5 млрд, которая по индексу Artificial Analysis обходит все открытые модели до 4 млрд.
С 1 по 9 сентября 2026 года в открытый доступ вышли модели на любой размер железа: Nex-N2.5-Max на 1,6 трлн параметров для кластера из 16 ускорителей H200, шесть моделей K2 Horizon от 0,9 до 375 млрд под Apache 2.0 и MiniCPM5-2B на 2,5 млрд, которая по индексу Artificial Analysis обходит все открытые модели до 4 млрд. Отдельно за неделю накопилось то, что обычно интереснее самих релизов: замеры, сколько памяти нужно локальной модели на самом деле, и ускорение инференса в llama.cpp.
Этот обзор продолжает августовский разбор открытых моделей . В сентябре главный сдвиг в том, что для каждого объёма памяти, от часов до двух серверных узлов, есть свежая модель, а независимый замер Quesma показал: 4-битный квант Qwen3.8-27B в 17 ГБ на трёх бенчмарках неотличим от полной версии в 55 ГБ. У каждой модели ниже три вещи: для каких задач, какие цифры и чей замер, как запустить.
Что вышло крупного и кому это по силам запустить?
Три больших релиза недели: Nex-N2.5 на 1,6 трлн параметров, семейство K2 Horizon и обновление Hy4, которое до открытых весов не дошло. Дома реально запускается только младшая K2 Horizon и, с натяжкой, Nex-N2.5-mini на двух H100.
Nex-AGI выложила Nex-N2.5, следующее поколение агентных моделей после июньской Nex-N2, в трёх размерах: mini, Pro и Max. Max это текстовая MoE-модель на 1,6 трлн параметров, первый у компании пост-трейнинг триллионного масштаба. Все три под Apache 2.0, контекст 262 144 токена. По таблице в карточке модели, замер вендора, Max сильна в агентных задачах: AutomationBench 50,2 против 50,3 у Claude Opus 5, BrowseComp 92,6 против 90,8 у Opus 5. В коде отстаёт: SWE-Bench Pro 65,7 против 79,2 у Opus 5. Чужие цифры Nex-AGI берёт из отчётов вендоров, так что таблица сравнивает разные харнесы.
Vision is therefore no longer merely an input modality; it has become a critical interface through which an agent perceives its environment, verifies outcomes, and moves a task forward. Команда Nex-AGI карточка Nex-N2.5 на Hugging Face (перевод: «Зрение больше не просто входная модальность, а интерфейс, через который агент воспринимает среду, проверяет результат и двигает задачу вперёд»)
Порог входа высокий. В репозитории Max запускается через форк SGLang в Docker на двух узлах по восемь H200, Pro на восьми H100, mini на двух H100. Mini и Pro есть на OpenRouter под именами nex-agi/nex-n2.5-mini и nex-agi/nex-n2.5-pro . Веса Pro в карточке только анонсированы, считать её открытой рано.
Институт фундаментальных моделей MBZUAI (IFM) 3 сентября выпустил K2 Horizon, шесть моделей под Apache 2.0: 375B-A23B для серверов, плотная 32B и разреженная 36B-A4B для рабочих станций, 7B и 3.7B для телефонов, 0.9B для часов и очков. Каждая обучена примерно на 20 трлн токенов. Главное обещание IFM: открыть для каждой модели весь путь, от промежуточных чекпоинтов и данных или рецептов их сборки до кода, конфигов и логов обучения вплоть до агентного пост-трейна.
A final checkpoint shows what a model can do. Horizon's complete training record helps reveal how it learned to do it. Institute of Foundation Models, MBZUAI блог о выпуске K2 Horizon (перевод: «Финальный чекпоинт показывает, что модель умеет. Полная запись обучения Horizon помогает понять, как она этому научилась»)
Самая интересная из шести для локального железа это K2-Horizon-MoVA-36B-A4B : 36 млрд параметров, около 4 млрд активных на токен, контекст 524 288 токенов. Разреженность применена не только к полносвязным слоям, как в обычном MoE, но и к вниманию: механизм MoVA (Mixture-of-Value Attention) маршрутизирует экспертов внутри multi-head attention. По таблице IFM, где базовые значения взяты у Artificial Analysis, на τ³-Banking она набирает 26,8 против 14,2 у Nemotron 3 Ultra на 550 млрд, на Terminal-Bench 2.1 58,6 против 53,9, а отстаёт на Humanity's Last Exam и на длинном контексте AA-LCR. Запуск из README:
vllm serve IFM/K2-Horizon-MoVA-36B-A4B \
--revision main \
--tensor-parallel-size 2 \
--enable-expert-parallel \
--trust-remote-code \
--dtype bfloat16 \
--max-model-len 131072 \
--reasoning-parser k2_horizon \
--tool-call-parser k2_horizon \
--enable-auto-tool-choice
Про Hy4 от Tencent важно не перепутать. Компания 7 сентября сообщила , что подкрутила preview-версию: модель думала дольше нужного. Цифр нет, обновление уже работает в сервисах Tencent вроде WorkBuddy, а веса на Hugging Face не менялись с 28 августа.
Что поместится на одну видеокарту или в ноутбук?
Четыре свежие модели (Granite 4.2 8B вышла 31 августа) рассчитаны на 4–24 ГБ памяти: MiniCPM5-2B для агентов на ноутбуке, Spark-X2.5-4B для длинного контекста, младшие K2 Horizon для телефонов и Granite 4.2 8B для дешёвых массовых запросов. Ни одна не заменит большую модель в знаниях, и это видно по бенчмаркам.
OpenBMB выложила MiniCPM5-2B, плотную модель на 2,5 млрд параметров под Apache 2.0, контекст 131 тыс. токенов, с вызовом инструментов и рассуждениями. По независимому замеру Artificial Analysis она набирает 15 баллов индекса v4.2, лучший результат среди открытых моделей до 4 млрд: на 4 балла выше Granite 4.2 3B и вровень с Qwen3.5 9B вчетверо большего размера. Сильная сторона агентные задачи: GDPval-AA v2 831 против 718 у Ling 3.0 Tiny, τ³-Banking 21%. Слабые места знания и терминал: Terminal-Bench 2.1 9% против 29% у Qwen3.5 9B. Зато токенов на задачу индекса уходит 19 тыс. против 56 тыс. у Ling 3.0 Tiny, а для ноутбука это и есть скорость ответа.
As a dense model, its size advantage is in memory footprint rather than active-parameter compute. Команда Artificial Analysis разбор выпуска MiniCPM5-2B, 7 сентября 2026 (перевод: «Поскольку модель плотная, её преимущество в размере это объём памяти, а не вычисления на активных параметрах»)
Под капотом, по README , три стадии пост-трейна: SFT на 400 млрд токенов, RL по доменам и дистилляция 16 экспертных RL-моделей, из них 5 агентных, обратно в одну модель. Запуск через vLLM по README:
pip install "vllm>=0.21"
vllm serve openbmb/MiniCPM5-2B --port 8000
Spark-X2.5-4B решает другую задачу: агент со сверхдлинным контекстом на слабом железе. Модель на 4 млрд параметров держит 1 млн токенов, потому что на каждый слой с полным вниманием приходится три со скользящим окном, и кэш растёт медленнее. Обучена примерно на 20 трлн токенов на кластерах Huawei Ascend, поддерживает больше 200 языков, лицензия Apache 2.0. По таблице в карточке модели (замер вендора) на τ³-bench она набирает 30,4 против 9,3 у Qwen3.5-9B, на остальных тестах идёт вровень с моделями своего размера. Есть версия на 1,7 млрд. Из README, запуск в vLLM через официальный образ:
docker run --rm --gpus all \
--ipc=host \
-p 30000:30000 \
-v "$MODEL_PATH:/models/Spark-X2.5-4B:ro" \
vllm/vllm-openai:latest \
--model /models/Spark-X2.5-4B \
--port 30000 \
--trust-remote-code \
--served-model-name spark25 \
--tensor-parallel-size 1 \
--gpu-memory-utilization 0.7 \
--enable-prefix-caching \
--chat-template /models/Spark-X2.5-4B/chat_template.jinja
Младшие K2 Horizon 0.9B, 3.7B и 7B IFM называет лучшими в своих классах; у 0.9B, по данным блога, больше 48 баллов на AIME 2026. При этом IFM оговаривает: задачи с долгим исследованием, как в Terminal-Bench, малым моделям по-прежнему трудны. Веса, а для большинства и FP8 с GGUF, лежат в коллекции на Hugging Face .
Granite 4.2 8B от IBM, плотная модель с рассуждениями и контекстом 131 072 токена под Apache 2.0, стоит на OpenRouter $0,06 за млн входных и $0,25 за млн выходных токенов. Индекс Artificial Analysis v4.3 всего 12,4 при 17,6 у Haiku 4.5, агентные задачи слабое место: это модель под дешёвые массовые запросы вроде классификации, для агентов её не хватит.
Сколько памяти реально нужно локальной модели?
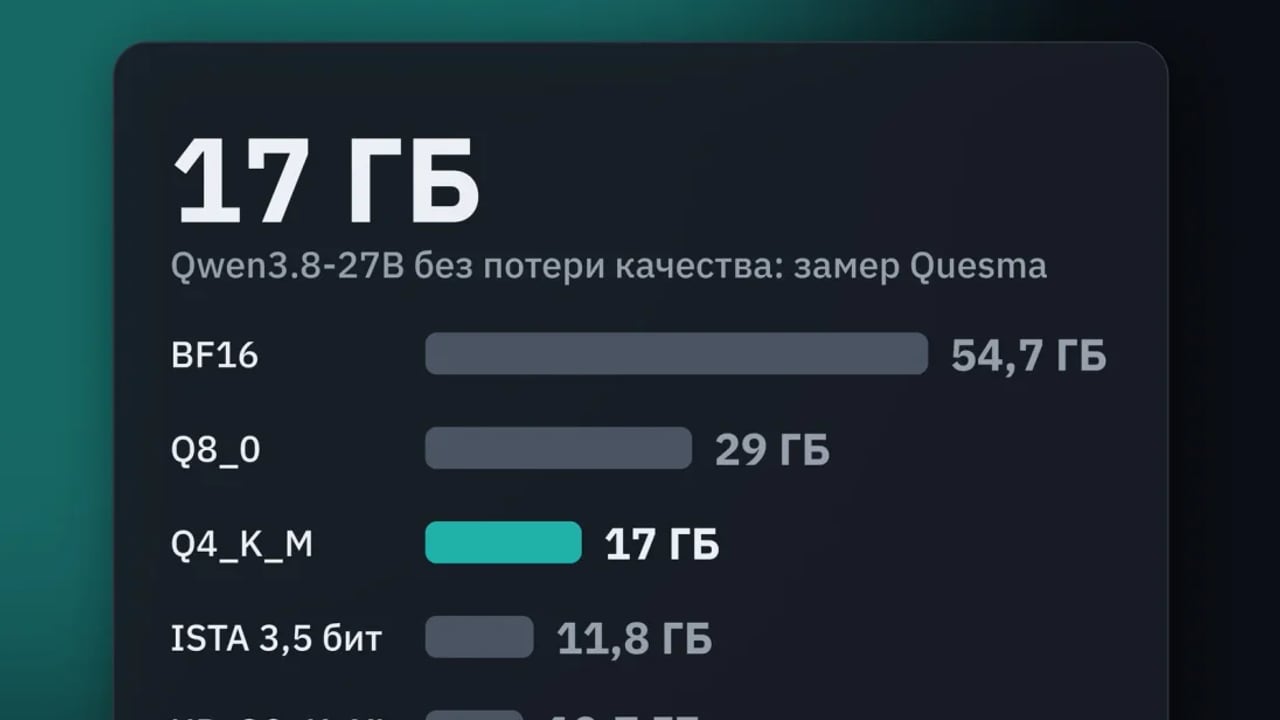
Для Qwen3.8-27B ответ измерен: 17 ГБ. Piotr Migdał из Quesma прогнал кванты от Unsloth через GPQA Diamond, IFBench и Terminal-Bench 2.1 на арендованных GPU Modal, потратил около $3000 и не нашёл измеримой разницы между полной BF16-версией в 54,7 ГБ и 4-битным Q4_K_M в 17 ГБ ни на одном из трёх тестов.
Цифры такие. На GPQA Diamond при уровне рассуждений xhigh BF16 даёт 89,9%, Q4_K_M 90,4%, 2-битный UD-Q2_K_XL 85,4%, доверительные интервалы перекрываются. На IFBench 81,7% против 81,0% и 80,0%. На Terminal-Bench 2.1 из 89 задач BF16 и Q4_K_M решили по 63, UD-Q2_K_XL 57.
In short, if you go with a 4-bit quantization Q4_K_M (17GB), you won't notice a difference on these benchmarks. Piotr Migdał автор замера, блог Quesma (перевод: «Коротко: если возьмёте 4-битный квант Q4_K_M на 17 ГБ, разницы на этих бенчмарках вы не заметите»)
На практике Quesma держала KV-кэш в F16, около 2,3 ГБ на 32 тыс. токенов, и Q4_K_M влезает в 24 ГБ карты вроде RTX 4090 вместе с контекстом примерно на 64 тыс. токенов. 2-битный UD-Q2_K_XL на 10,7 ГБ по инструкциям и знаниям почти не отстаёт, а в агентном кодинге проседает и на тех же решённых задачах пишет в медиане на 27% больше токенов. 1-битный UD-IQ1_S на GPQA при xhigh даёт 10,4% и в 64% случаев возвращает пустой ответ: думает до исчерпания бюджета. Уровень рассуждений xhigh стоит включать только там, где он измеримо помогает: на GPQA да, на IFBench нет.
Ещё сильнее ужалась лаборатория DASLab австрийского института ISTA. Её кванты GSQ-RCO той же Qwen3.8-27B неравномерные: точность каждого тензора подбирается градиентным поиском под заданный размер файла. Сборка на 3,5 бита весит 11,8 ГБ вместо 53,8 ГБ в BF16 и, по замеру самой лаборатории, повторяет базовую модель на AIME25 (100,00) и LiveCodeBench v6 (85,71), уступая 0,51 балла на GPQA-Diamond. Это обычные GGUF, работают в llama.cpp, Ollama и LM Studio:
# download (requires: pip install -U "huggingface_hub[cli]")
hf download ISTA-DASLab/Qwen3.8-27B-GSQ-RCO-GGUF Qwen3.8-27B-GSQ-RCO-IQ3_S.gguf --local-dir .

llama-cli -m Qwen3.8-27B-GSQ-RCO-IQ3_S.gguf -p "Explain mixed-precision quantization." -ngl 99

# или через Ollama, выбрав файл под свой объём памяти
ollama run hf.co/ISTA-DASLab/Qwen3.8-27B-GSQ-RCO-GGUF
Для тех, у кого памяти много, а модель большая, новость недели это скорость GLM-5.3-Flash. Unsloth 4 сентября дописала свой pull request в llama.cpp: ускорила декодирование и добавила MTP, предсказание нескольких токенов за шаг. Кванты те же, докачивать ничего не нужно. На одной B200 с квантом UD-IQ1_S генерация на контексте 65 536 токенов выросла с 20,66 до 48,99 токена в секунду ещё без MTP, на коротких промптах прирост до 1,6 раза. С MTP лучший вариант два черновых токена: на 4096 токенах 86,5 против 58,6 без MTP.
However we should stop at around n=2 as more draft tokens makes inference slower. Команда Unsloth документация по запуску GLM-5.3-Flash (перевод: «Но стоит остановиться примерно на n=2: больше черновых токенов замедляют инференс»)
Требования не изменились: 1-битный квант в 100 ГБ памяти, 3-битный в 128 ГБ, как у Mac Studio или DGX Spark. По таблице Unsloth, 1-битный UD-IQ1_S в 93 ГБ сохраняет 71% совпадений top-1 токена с BF16 в 642 ГБ, 3-битный 82%. С учётом результата Quesma по 1-битным квантам Qwen3.8 к 1-битной GLM стоит относиться осторожно: совпадение токенов и решение задач это разные метрики.
Наконец, llama.cpp 0.4.0 , очередной сводный релиз, которые проект теперь собирает из ежедневных билдов раз в несколько недель. Что важно локальщику:
- Новые архитектуры: Qwen3.8-Flash-Next (пока без оптимизаций), Nemotron-3-Puzzle 75B с 9 млрд активных, DSpark для Nemotron 3.5.
- Разреженное flash attention для DeepSeek-V4, GLM и Qwen3.8-Flash-Next; ggml обновлён до 0.23.0.
- Ленивое чтение тензоров --lazy-mode : большие тензоры читаются по мере надобности, а пик памяти при загрузке убран.
- Потолок рабочей памяти квантизатора: раньше один большой тензор мог съесть всю оперативку.
- Сервер: лимит контекста на слот, видео на вход через --video-* , медиа через data: -ссылки, preserve_reasoning по умолчанию.
Что нового не только для текста?
Картинки, речь, вождение, временные ряды и видео. Под Apache 2.0 или MIT четыре модели из шести: TimesFM 3.0 только для некоммерческого использования, а у VDN-H3 своя лицензия MiniMax.
LLaDA-Image. Ant Group выложила модель на 6 млрд параметров, которая одним чекпоинтом и генерирует картинки, и редактирует их по инструкции; и языковой бэкбон, и картиночная часть диффузионные. Базовая версия работает за 50 шагов, Turbo за 4. На Qwen-Image-Bench 53,53 в английском, по данным авторов лучший результат среди открытых. Веса под Apache 2.0, есть FP8 и демо Turbo ; код проверен на Python 3.11, PyTorch 2.8 и Diffusers 0.39.0.
Ling-3.0-flash-VL. Та же Ant Group показала зрячую версию Ling-3.0-flash (MoE, 5,5 млрд активных из 124) с таблицей против Qwen3.8-27B и Gemini 3.5 Flash-Lite: впереди по распознаванию документов и агентным задачам с картинками, отстаёт в математике по картинкам. Веса выложены на Hugging Face 8 сентября под MIT, есть FP8-версия.
VibeVoice-ASR-Streaming. Microsoft Research открыла потоковое распознавание речи, которое сразу пишет, кто что сказал, без отдельного этапа диаризации. Десять языков, русский в списке. По отчёту авторов , 7B-версия по доле ошибок в среднем лучше Gemini 3.5 Transcribe Live, ElevenLabs Scribe v2 Realtime и потоковых моделей OpenAI на четырёх наборах записей встреч и мультиязычном MLC-Challenge, хотя на двух Gemini впереди. Версии 1,5B и 7B под MIT, код на GitHub ; список терминов, чтобы модель их не коверкала, передаётся флагом --context_info .
Qwen-Drive-1.0. Qwen вместе с Хуачжунским университетом выложила модель для беспилотного вождения на базе Qwen3.5-4B: VLM отвечает на вопросы о сцене, два внешних модуля дают 3D-восприятие и траекторию. На NAVSIM v1.1 планировщик после RL даёт 90,7 PDMS (замер авторов). Apache 2.0, VLM весит 9,1 ГБ, нужна карта от 24 ГБ.
TimesFM 3.0. Модель Google для прогноза временных рядов научилась прогнозировать несколько связанных рядов сразу и, по данным авторов, держит первое место на fev-bench и GIFT-Eval. Ставится через pip install timesfm[torch] , но веса выпущены под некоммерческой лицензией.
VDN-H3. Ускоренная версия MiniMax-H3 для генерации видео со звуком: к сети добавили линейную ветку внимания по кадрам и два LoRA-адаптера. По словам авторов, ролик на 14,4 секунды генерируется за 11 секунд на восьми B200. Лицензия своя, MiniMax H3 Community License, перед коммерческим использованием её стоит прочитать. Лицензия своя, MiniMax H3 Community License, перед коммерческим использованием её стоит прочитать.
Что для какой задачи брать в сентябре 2026?
Короткий ответ: выбирать стоит по задаче и объёму памяти, размер в названии вторичен. Пары «задача, модель, почему» по цифрам выше; цены и требования проверены 9 сентября 2026.
- Агент на слабом железе : MiniCPM5-2B. Лучший индекс Artificial Analysis до 4 млрд, 19 тыс. токенов на задачу, есть GGUF и MLX, Apache 2.0.
- Агент с огромным контекстом на одной карте : Spark-X2.5-4B. 1 млн токенов при 4 млрд параметров, τ³-bench 30,4 против 9,3 у Qwen3.5-9B по замеру вендора.
- Локальный кодинг на 24 ГБ : Qwen3.8-27B в кванте Q4_K_M от Unsloth (17 ГБ) или GSQ-RCO IQ3_S от ISTA (11,8 ГБ). Сравнения двух между собой на Terminal-Bench никто не публиковал.
- Терминальный агент на рабочей станции : K2-Horizon-MoVA-36B-A4B. 4 млрд активных, Terminal-Bench 2.1 58,6 по замеру IFM, контекст 524 тыс.
- Кодинг на 128 ГБ памяти : GLM-5.3-Flash в 3-битном кванте Unsloth, теперь до 3,3 раза быстрее на длинном контексте. Про цену решённой задачи в API есть отдельный разбор .
- Распознавание встреч с указанием, кто говорил : VibeVoice-ASR-Streaming-7B. Стриминг, диаризация внутри, русский в списке, MIT.
- Картинки и правка по инструкции : LLaDA-Image-Turbo, 4 шага, есть FP8, Apache 2.0.
- Прогноз временных рядов : TimesFM 3.0, только для исследований из-за некоммерческой лицензии.
- Дешёвые массовые запросы через API : Granite 4.2 8B, $0,06 и $0,25 за млн токенов на OpenRouter; для агентов её не хватит.
Правило из замера Quesma, которое по опыту редакции Tproger подтверждается: берите самую большую модель, которая помещается в память вместе с нужным контекстом, и не бойтесь 4-битных квантов. 1-битные для задач с рассуждениями не годятся.
Что происходит вокруг и чего ждать дальше?
Вокруг релизов три события задают контекст, и все три об одном: открытые веса стали коммерческой стратегией.
Vals AI 31 августа опубликовала полные результаты GLM-5.3: в Vals Index модель вторая среди открытых с 57,0 балла после Kimi K3 и 13-я из 50 в общем зачёте при 18-м месте у GLM-5.2. Это объясняет, почему GLM-5.3 и GLM-5.3-Flash держатся в топе загрузок Hugging Face вторую неделю.
Mistral 8 сентября объявила , что подняла €3 млрд при оценке больше €21 млрд; по словам компании, это крупнейший акционерный раунд в истории европейских технологических компаний. Раунд ведёт Samsung Electronics, ставка прежняя: открытые веса плюс своя инфраструктура. Новых моделей в анонсе нет.
DeepSeek открыла бету V4.1 Flash: модель deepseek-v4.1-flash-expires-on-0910 живёт в API до 10 сентября, веса не выложены, официальных бенчмарков нет, так что в обзор она не попадает; о закрытых моделях речь в разборе за август . Что проверить дальше: выйдут ли веса Nex-N2.5-Pro, доедет ли доработка Unsloth в основной llama.cpp и обновит ли Tencent веса Hy4.
Q4_K_M от Unsloth на 17 ГБ: по замеру Quesma он не отличается от BF16 на трёх бенчмарках и оставляет место под контекст около 64 тыс. токенов. Если нужно меньше, GSQ-RCO IQ3_S от ISTA на 11,8 ГБ повторяет базовую модель на AIME25 и LiveCodeBench по замеру ISTA.
Max нет: два узла по восемь H200. Mini по README запускается на двух H100 через форк SGLang в Docker, а без своего железа mini и Pro доступны на OpenRouter. Веса Pro на 9 сентября ещё не выложены.
Для запуска ничего: веса и GGUF лежат на Hugging Face под Apache 2.0. Разница проявится, когда захотите дообучить модель или воспроизвести стадию обучения: IFM обещает чекпоинты, данные или рецепты, код, конфиги и логи для каждой из шести моделей.
Нет. Кванты Unsloth те же, что и раньше. В Unsloth Desktop достаточно обновить приложение, в llama.cpp нужно собрать ветку Unsloth по их гайду; в основной релиз llama.cpp 0.4.0 эти доработки не входят.
Nex-N2.5, K2 Horizon, MiniCPM5-2B, Spark-X2.5, LLaDA-Image, Qwen-Drive-1.0 и Granite 4.2 под Apache 2.0, VibeVoice-ASR-Streaming под MIT. Ling-3.0-flash-VL тоже под MIT. TimesFM 3.0 нельзя: у весов некоммерческая лицензия. У VDN-H3 своя лицензия MiniMax, читать перед использованием.
Источники: Карточка Nex-N2.5-Max на Hugging Face , Репозиторий Nex-N2.5 на GitHub: команды запуска , IFM: Introducing K2 Horizon , Карточка K2-Horizon-MoVA-36B-A4B , Коллекция K2 Horizon на Hugging Face , Artificial Analysis: OpenBMB releases MiniCPM5-2B , Карточка MiniCPM5-2B на Hugging Face , Репозиторий MiniCPM на GitHub , Карточка Spark-X2.5-4B на Hugging Face , Quesma: Benchmarking Qwen3.8 27B quantizations , ISTA-DASLab: Qwen3.8-27B GSQ-RCO GGUF , Unsloth: GLM-5.3-Flash, how to run locally , Релиз llama.cpp v0.4.0 , LLaDA-Image на GitHub , Карточка VibeVoice-ASR-Streaming-7B , Qwen-Drive-1.0 на GitHub , TimesFM на GitHub , Granite 4.2 8B на OpenRouter , Mistral: раунд на €3 млрд , Vals AI: результаты GLM-5.3